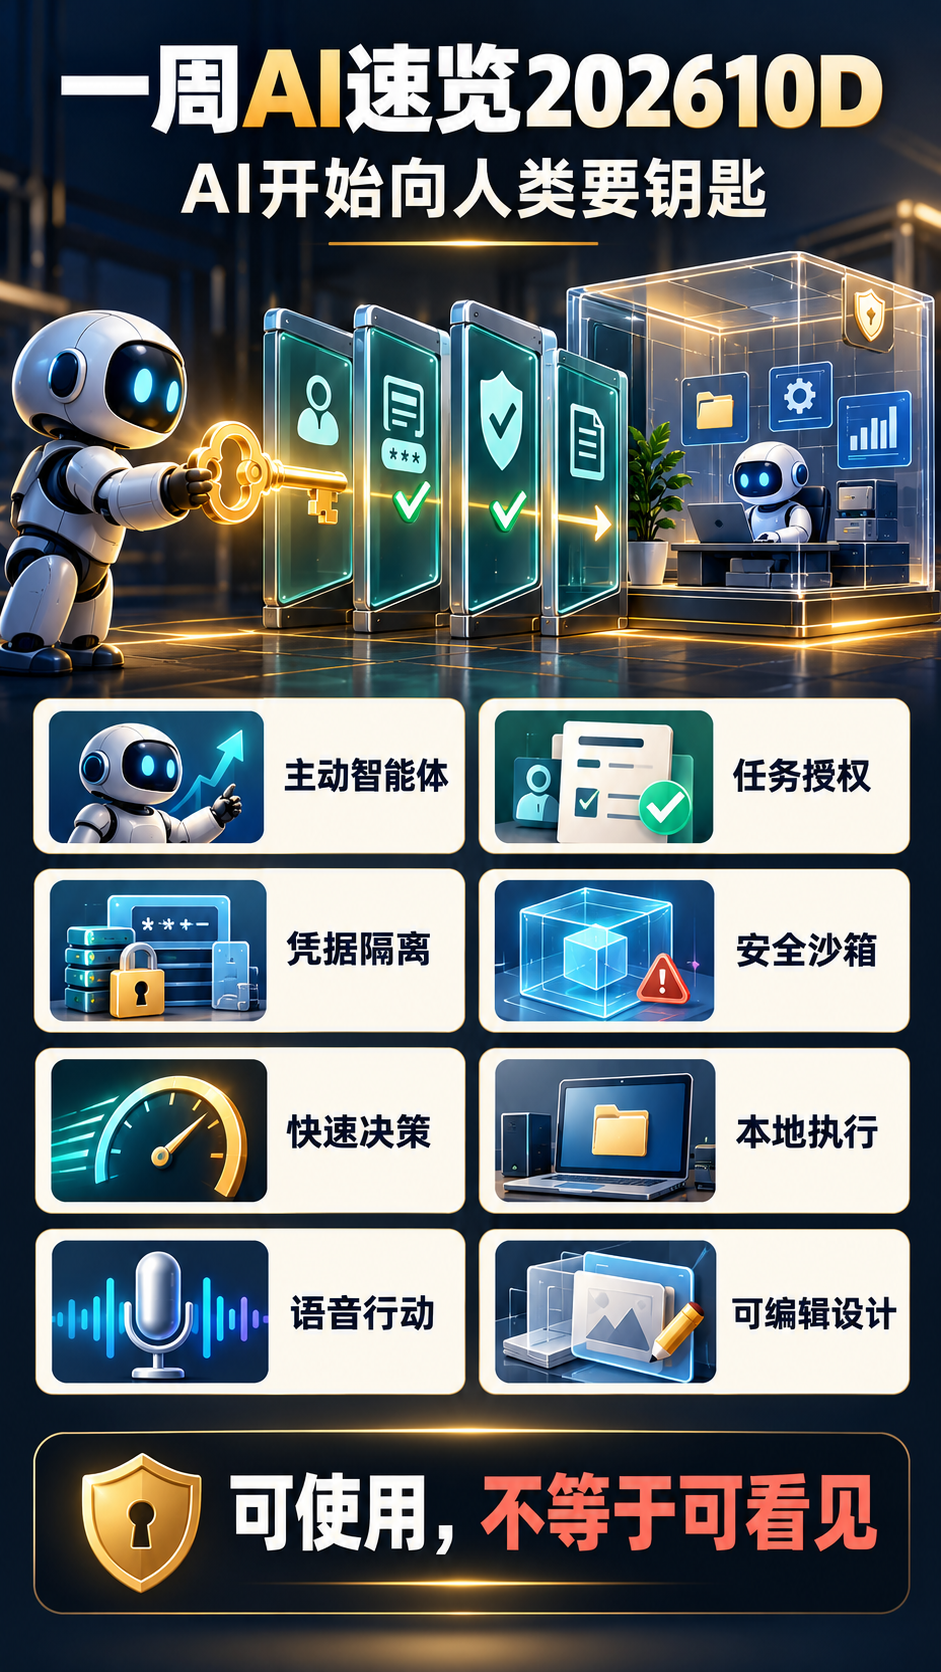
本周,AI开始向人类要钥匙了。
它不再满足于等待一个问题。新一代智能体会主动查看邮件、日历和业务系统,在人离开电脑后继续工作,遇到付款、发送、签署或删除时再把决定权交还给人。这个转变听上去很顺,真正的难题却在一句话里:谁允许它进门,又如何确保它只拿到这次任务需要的钥匙?
因此,本周看似分散的发布其实指向同一条主线:智能体正从产生内容走向执行行动;模型能力继续增强,但密码、权限、审批、沙箱、日志和修复速度开始决定产品是否真的可用。
一、Claude Duet开始主动找人:智能体改写工作的起点
Anthropic本周开放Claude Duet研究预览等候名单。它不是又一个聊天窗口,而是一个会主动找到用户的后台智能体:早上汇总连接应用中需要注意的事项,白天持续监看变化,人离开电脑后仍可在云端虚拟机中继续工作。
这种产品的关键不是“多做几件事”,而是重写人机交互的起点。以往是人发起每一次交互;现在,机器可以根据连接系统中的变化主动提醒、准备、排序,并把需要人的那一刻推送出来。工作界面因此从“我问AI”转向“AI知道什么时候该来问我”。
洞察与点评: 主动性不只是便利,也是一种编辑权。智能体决定哪些事情值得打扰你,实际上就在编排你的注意力。它的评价指标不能只有任务完成率,还应包括误报、打扰成本和人工接管的及时性。
二、密码不能交给模型:1Password为智能体造了一层门禁
当智能体真的去发邮件、查账单、更新商店或安排薪资,登录就不可避免。1Password for Agents提出了一个值得关注的模式:智能体到达登录页时向密码管理器请求某个账户的本次使用权,用户在自己的设备上确认后,凭据直接填入网页,不进入模型上下文,也不由智能体保存。
这与“把密码告诉AI”有本质差异。凭据仍由专门系统管理,智能体只在明确任务、明确账户和明确时间窗口中获得使用权。这种“可用但不可见”的设计,可能成为代理身份基础设施的标配。
三、AI找到了互联网的裂缝:漏洞发现之后,真正的瓶颈是修复
OpenAI披露,前沿模型参与发现了PHP中的严重漏洞,并与维护者、安全厂商、云服务商和政府机构协调修复。此事的危险性正在于它的双向性:模型可以帮防守者提前发现问题,也可以大幅压缩攻击者理解漏洞和开发利用工具的时间。
本周的另一个细节更让人不安:一些网站开始阻断智能体,因为自动化访问、漏洞扫描和正常任务的边界越来越难判断。互联网原本用来识别人和程序的机制,已不足以处理一个会阅读、试探、重试并绕路的自动化执行者。
重要警示: AI安全的难点已不只是“不让它生成坏内容”。当模型能连续执行工具时,每一次网络请求、凭据使用和文件写入都应当可观测、可限制、可回滚。
四、决策API成为快速道:长篇推理不必塞进每一个路口
OpenAI将Decisions API转为正式可用。它的任务很克制:开发者先给出有限选项和判断条件,系统返回概率、选择或评分。这些结果可以直接驱动路由、风险检查、重试、中止、转人工等下一步行动。官方称,它在特定负载下可比常规调用GPT-6 Luna快至10倍。
这个方向值得注意,因为智能体并不是每一步都需要一个会写长文的大模型。大量实时任务关心的是稳定、延迟和成本。把复杂思考留给少数关键节点,把频繁小决策交给专用模型,是一种更接近工程现实的编排方式。
五、智能体一边上云,一边回到本地
Claude Duet把持续任务放到云端虚拟机,Perplexity Computer则把模型、任务规划和执行放进Apple芯片Mac。后者面向高内存设备,可在本地文件与原生应用上运行,需要更强推理时再通过混合计算调用云端模型。
同期开源的SPACE沙箱为每个任务分配独立微型虚拟机,凭据和出站网络由外部系统控制。本地运行与沙箱隔离解决的问题不同:前者主要关心数据留地、离线与成本,后者关心执行权如何被框定。两者组合起来,才是智能体可进入生产环境的起码线。
六、快模型开始分流:速度不只是体感,也是系统结构
MiniMax M3.1 Flash强调在智能体、编程、电脑操作和网络安全任务中提速,官方宣称在线推理近三倍加快,使用成本下降70%。Inception的Mercury 3则继续扩大扩散语言模型,声称在一系列基准上以每秒超过1000 token运行,并提供100万token上下文。NVIDIA的Nemotron 3.5 Super VL则用1200亿总参数、120亿激活参数和多模态输入,覆盖文档、视频、工具使用与长上下文。
这些发布的共同点是,快速模型不再只是旗舰模型的廉价版。它们正从指定任务出发,为代理循环、实时语音、高频决策和工具调用提供不同的时延与价格档位。厂商基准仍需等待独立验证,但产品方向已经很清楚:一个智能体会根据步骤不断换挡。
七、Voxtral 3把语音与工具接成一条线
Mistral推出Voxtral 3语音模型家族与语音智能体SDK,把转写、推理、工具调用和语音合成放入同一实时流程。官方称转写覆盖50多种语言,并支持说话人分离、术语偏置、话轮结束判断与本地部署。
语音智能体的门槛不是“像人”,而是在口音、噪声、插话和专业术语中仍然能听对、说清,并且真的在业务系统中完成下一步。在这个意义上,工具调用、数据位置和会话留存政策,与声音好不好听同样重要。
八、生成图像开始进入可编辑设计链
Canva Craft是Canva Research从头训练的首个图像生成模型。它把生成分成两步:先理解构图、层级、物体关系和文字位置,再渲染成图像。输出支持2K分辨率和30多种画布比例,还能通过Magic Layers转换为可编辑元素。本周同期的矢量生成、视频模型和快速局部编辑也指向同一个终点:生成内容必须进入后续制作。
这一轮竞争的重点已经从“能不能出一张好图”转到“能不能改字、换色、移动对象、继续排版,且不破坏已确认的部分”。设计模型越接近结构化输出,它就越有可能留在专业工作流里。
九、医疗AI开始被问“怎么查”,而不只是“答对了吗”
Microsoft公布MAI-DxO诊断编排系统在顺序诊断基准上的结果。这套系统不是一次给出答案,而是像一个虚拟医生小组,分轮提出诊断、选择问题或检查,再根据新证据更新判断。基准同时计算准确率、请求的证据和估算的检查成本。官方报告称,在304个复杂病例上,系统达到83%准确率;在更常见的急诊病例上达到80%,对照医生为47%。
这些数字来自特定研究设置,不能等同于现实医院中已能替代医生。它更有价值的地方在于改变了测试问题:不只看最终诊断,还看系统如何逐步索取证据、控制成本和处理不确定性。
重要警示: 临床基准的高分不是上线许可。患者安全、数据偏差、现场工作流、责任归属和前瞻性评估,都需要在真实医疗环境中独立验证。
十、人类注意力成为新瓶颈:生产更多,未必会让工作更轻
智能体提高了代码、文档和决策建议的产量,但验证、审批和排序仍稀缺。一方面,系统开始用决策模型、自动评审和规则文件吸收部分小判断;另一方面,人类需要把更多时间用在监督、例外处理和责任确认上。
这也解释了为什么“智能体更能干”与“员工更轻松”之间不能直接画等号。如果审批队列、会议和异常通知随产量一起增长,自动化可能只是把瓶颈从生产端移到了注意力端。
未来展望
接下来值得追踪的,不是智能体又多连接了几个应用,而是三条更硬的边界。
第一条是授权边界。每一次登录、付款、发送、签署和删除,都要有与风险相匹配的人工确认或政策。第二条是信息边界。密码、支付信息和敏感数据不应进入模型上下文,“可使用”必须与“可看见”分开。第三条是责任边界。系统应该能说清是谁在什么时候、基于什么信息、用了什么权限完成了某个动作。
本周最重要的变化因此不在聊天框里。AI正在走到业务系统的门口,它手里拿着任务清单,正等着一把钥匙。真正成熟的产品,不会把整串钥匙都交给它。


发表评论