当伪造变得容易,证明就变得昂贵
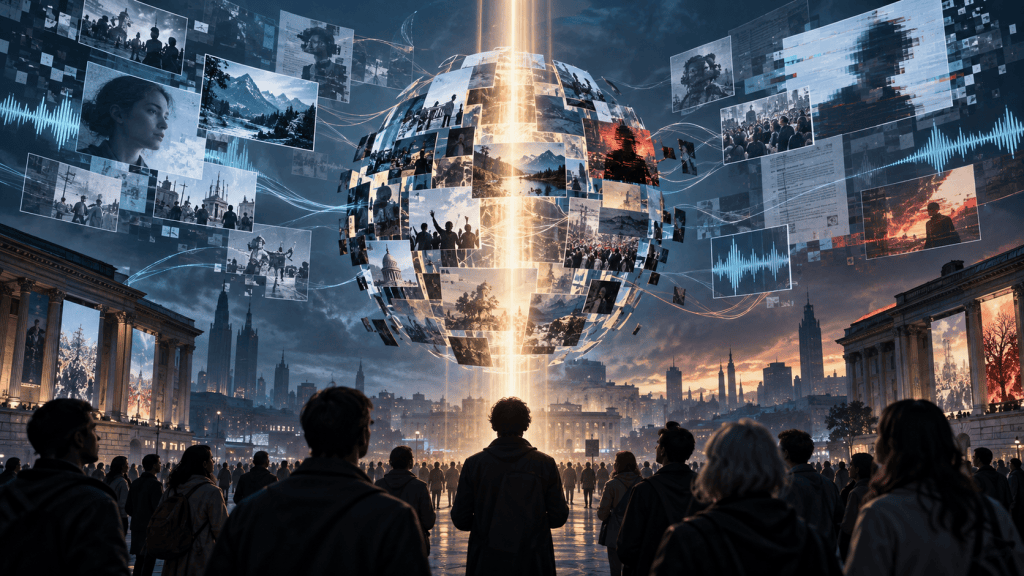
一段语音听起来像家人,一张照片像现场拍摄,一份报告有图表、有引文,甚至能找到另一篇报告替它作证。它们都可能是真的,也都可能经过合成或拼接。生成式AI带来的变化,不只是“假内容更多”,更是制作可信外观的成本下降了,而核验来源仍然费时。
这会给公共讨论带来一种新的负担:记者、学校、法院、平台和普通读者,都得花更多力气判断材料从哪里来、是否完整、有没有被改动。合成内容并不天然有害——翻译、辅助表达、艺术创作都能从中受益。问题在于,生产能力增长得很快,社会的核验能力却未必跟得上。
共同现实,不等于所有人意见一致
所谓“共同现实”,不是要求人们相信同一种解释,而是大家仍有办法围绕证据争论:材料由谁发布?原始记录在哪里?这句话是亲历、推断还是转述?不同结论能否接受核查?
如果这些问题越来越难回答,争论就可能从“证据说明什么”滑向“任何证据都可能是假的”。这并不需要每个人都相信同一条谎言。只要足够多人不再相信任何材料,真实的指控也会更难被听见,作假者反而多了一层退路。
生成工具可以迅速制作文字、图片和声音,也能针对不同受众改写同一信息。但不能因此简单断言“AI操纵了公众”。传播效果还取决于平台推荐、政治组织、既有偏见、媒体习惯和线下事件。更准确的问题是:合成技术是否让制造、定向投放和反复包装信息变得更便宜,同时让核验更慢?
AI事故数据库能帮助研究者记录已经公开报道的伤害类型,却不能直接告诉我们社会中AI伤害的真实发生率。哪些事件被报道、如何定义、重复记录如何处理,都会影响数据库。AI Incident Database研究快照与OECD事件监测方法说明适合用来观察事件类别和收集方法,不宜被当作总体统计。
谁在替我们筛选可信信息
尤瓦尔·赫拉利长期讨论语言、故事与社会制度的关系;他的公开问答呈现的是思想判断,而不是关于AI改变公众信念的实验数据。赫拉利问答贾伦·拉尼尔则提醒人们,不要把模型想象成脱离人类组织的独立人格;我们还要看平台、数据和商业安排。拉尼尔文章
两种视角都重要。只谈模型的说服力,容易把它夸成无所不能;只谈平台和组织,又可能低估自动生成内容的规模。判断责任,至少要问:谁训练系统,谁选择传播场景,谁控制推荐,谁能纠正错误?受影响的人能否拒绝、申诉或退出?
儿童尤其需要保护。UNICEF的“AI for Children”项目汇集了儿童权利与AI相关的政策资源,但不是对长期影响的统一测量。项目页面提醒我们,儿童既可能获得学习帮助,也可能面对错误信息、隐私暴露或不适龄互动。长期影响尚未完全明朗,不能被写成已经证实的普遍伤害;但儿童难以与平台平等谈判,成人机构有责任提供清楚说明、最少化数据收集、退出机制和真实的人类照护。
不让怀疑吞掉求证
合成信息带来的深层风险,是“反正都可能是假的”逐渐成为默认反应。水印和来源凭证有用,但不能单独恢复信任;媒体素养也重要,却不能把整个核验负担推给个人。还需要平台承担来源说明责任,公共机构用可验证的渠道发布材料,独立新闻和事实核查有稳定资源,受害者能够申诉并获得纠正。
教皇方济各在2024年G7讲话中强调,人的判断与尊严不能被简化为效率计算。讲话原文这是伦理论述,不是经验研究;但它提出了一个值得保留的问题:当系统替人筛选信息和给出判断时,谁还负责解释、承担后果并听取异议?
公共现实从来不意味着没有争议。它意味着争议仍受证据约束,错误仍有被纠正的机会。内容越容易合成,可信的来源、公开的核验程序和允许更正的制度就越不可缺少。
科幻镜头。《黑客帝国》常被拿来形容“虚假现实”,但它最有用的哲学问题并非机器是否会真的把人类接入某种模拟,而是:当感知、证言和证据渠道都可能被操纵,个体凭什么确认共同世界仍然存在?这只是认识论思想实验。现实中的深度伪造、错误传播和信任变化,必须由平台数据、调查与事件研究支持,不能由电影情节推出。
主要来源
- Harari, Yuval Noah. FAQ. https://www.ynharari.com/faqs/
- Lanier, Jaron. “The Myth of AI” / agent-alien argument. https://jaronlanier.com/agentalien.html
- Pope Francis. Address to the G7 on Artificial Intelligence (2024). https://www.vatican.va/content/francesco/en/speeches/2024/june/documents/20240614-g7-intelligenza-artificiale.html
- AI Incident Database. Research snapshots. https://incidentdatabase.ai/research/snapshots
- OECD.AI. AI Incidents Monitor methodology. https://oecd.ai/en/incidents-methodology
- UNICEF Innocenti. “AI for Children.” https://www.unicef.org/innocenti/projects/ai-for-children
- Bender, Emily M. et al. “On the Dangers of Stochastic Parrots.” FAccT (2021). https://dl.acm.org/doi/10.1145/3442188.3445922


发表评论